Qwen 3.5 397B-A17B · GB200 NVL72 · 精度对比
GB200 NVL72: FP4 vs FP8 精度对比
在 GB200 NVL72(NVIDIA Blackwell)上对比 FP4 与 FP8 精度对 Qwen 3.5 397B-A17B 推理的影响。涵盖各类 LLM 工作负载的吞吐量、延迟与成本。使用下方图表控件切换序列和指标——交互方式与主推理图表相同。
FP8:6147 tok/s/Chip,每百万 token $0.09(Qwen 3.5 397B-A17B(GB200 NVL72)上以 135 tok/s/user 运行)。FP4 在此点尚未测试。
在 Qwen 3.5 397B-A17B(GB200 NVL72)上以 224 tok/s/user 运行时,FP8 吞吐量为 2182 tok/s/Chip,每百万 token 成本 $0.24;FP4 在此目标点没有基准测试数据。
FP8 在 Qwen 3.5 397B-A17B(GB200 NVL72)上以 312 tok/s/user 运行时达到 1089 tok/s/Chip(每百万 token $0.47)。FP4 在此工作点没有数据。 (数据反映此 URL 的默认 8k/1k 选择——如果您在控件中更改序列或模型,下方表格和图表会自动更新。每一侧取该精度下的最优可用推理配置,可能包含投机解码(如 MTP)——与其他对比页面的口径一致。)
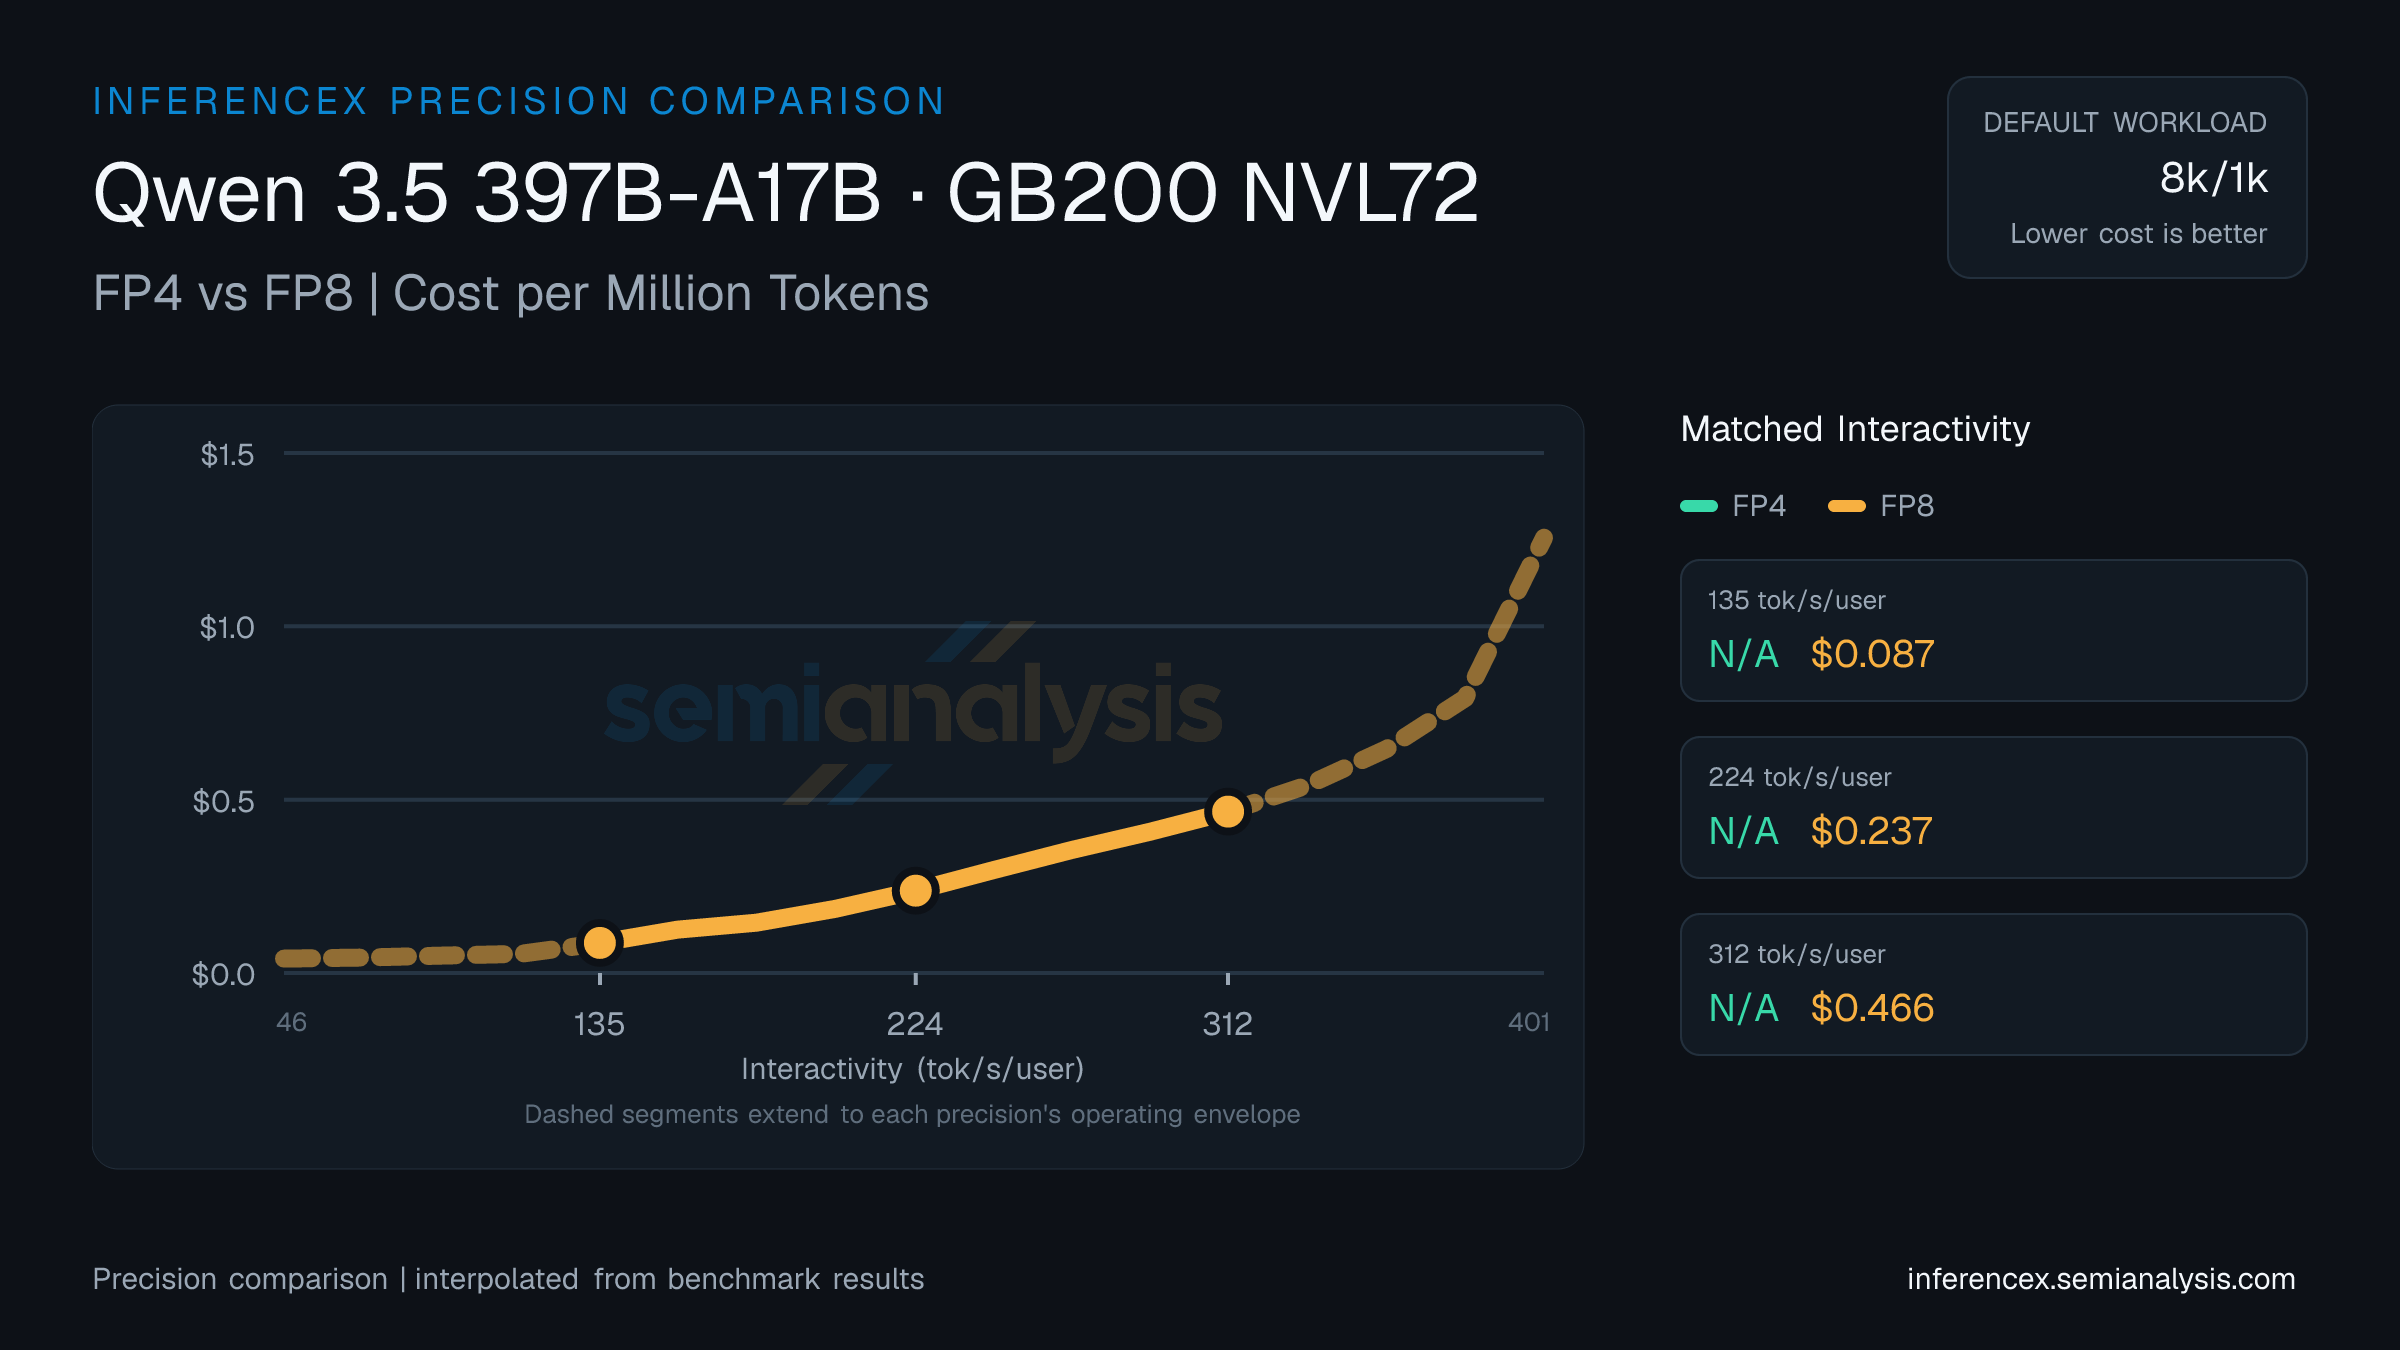
Interpolated from real benchmark data. Edit target interactivity values below to compare at different operating points.
| Metric | Interactivity (tok/s/user) | Interactivity (tok/s/user) | Interactivity (tok/s/user) |
|---|---|---|---|
| Throughput (tok/s/chip) | FP4:—FP8:6147.0 | FP4:—FP8:2181.8 | FP4:—FP8:1089.4 |
| Cost ($/M tok) | FP4:—FP8:$0.087 | FP4:—FP8:$0.237 | FP4:—FP8:$0.466 |
| tok/s/MW | FP4:—FP8:3287163 | FP4:—FP8:1166737 | FP4:—FP8:582554 |
| Concurrency | FP4:—FP8:~238 | FP4:—FP8:~17 | FP4:—FP8:~4 |
推理性能
不同模型、硬件配置和服务参数下的推理性能指标。
厂商:
部署模式:
投机解码: