Qwen 3.5 397B-A17B — GB300 NVL72 vs RTX PRO 6000 每美元性能
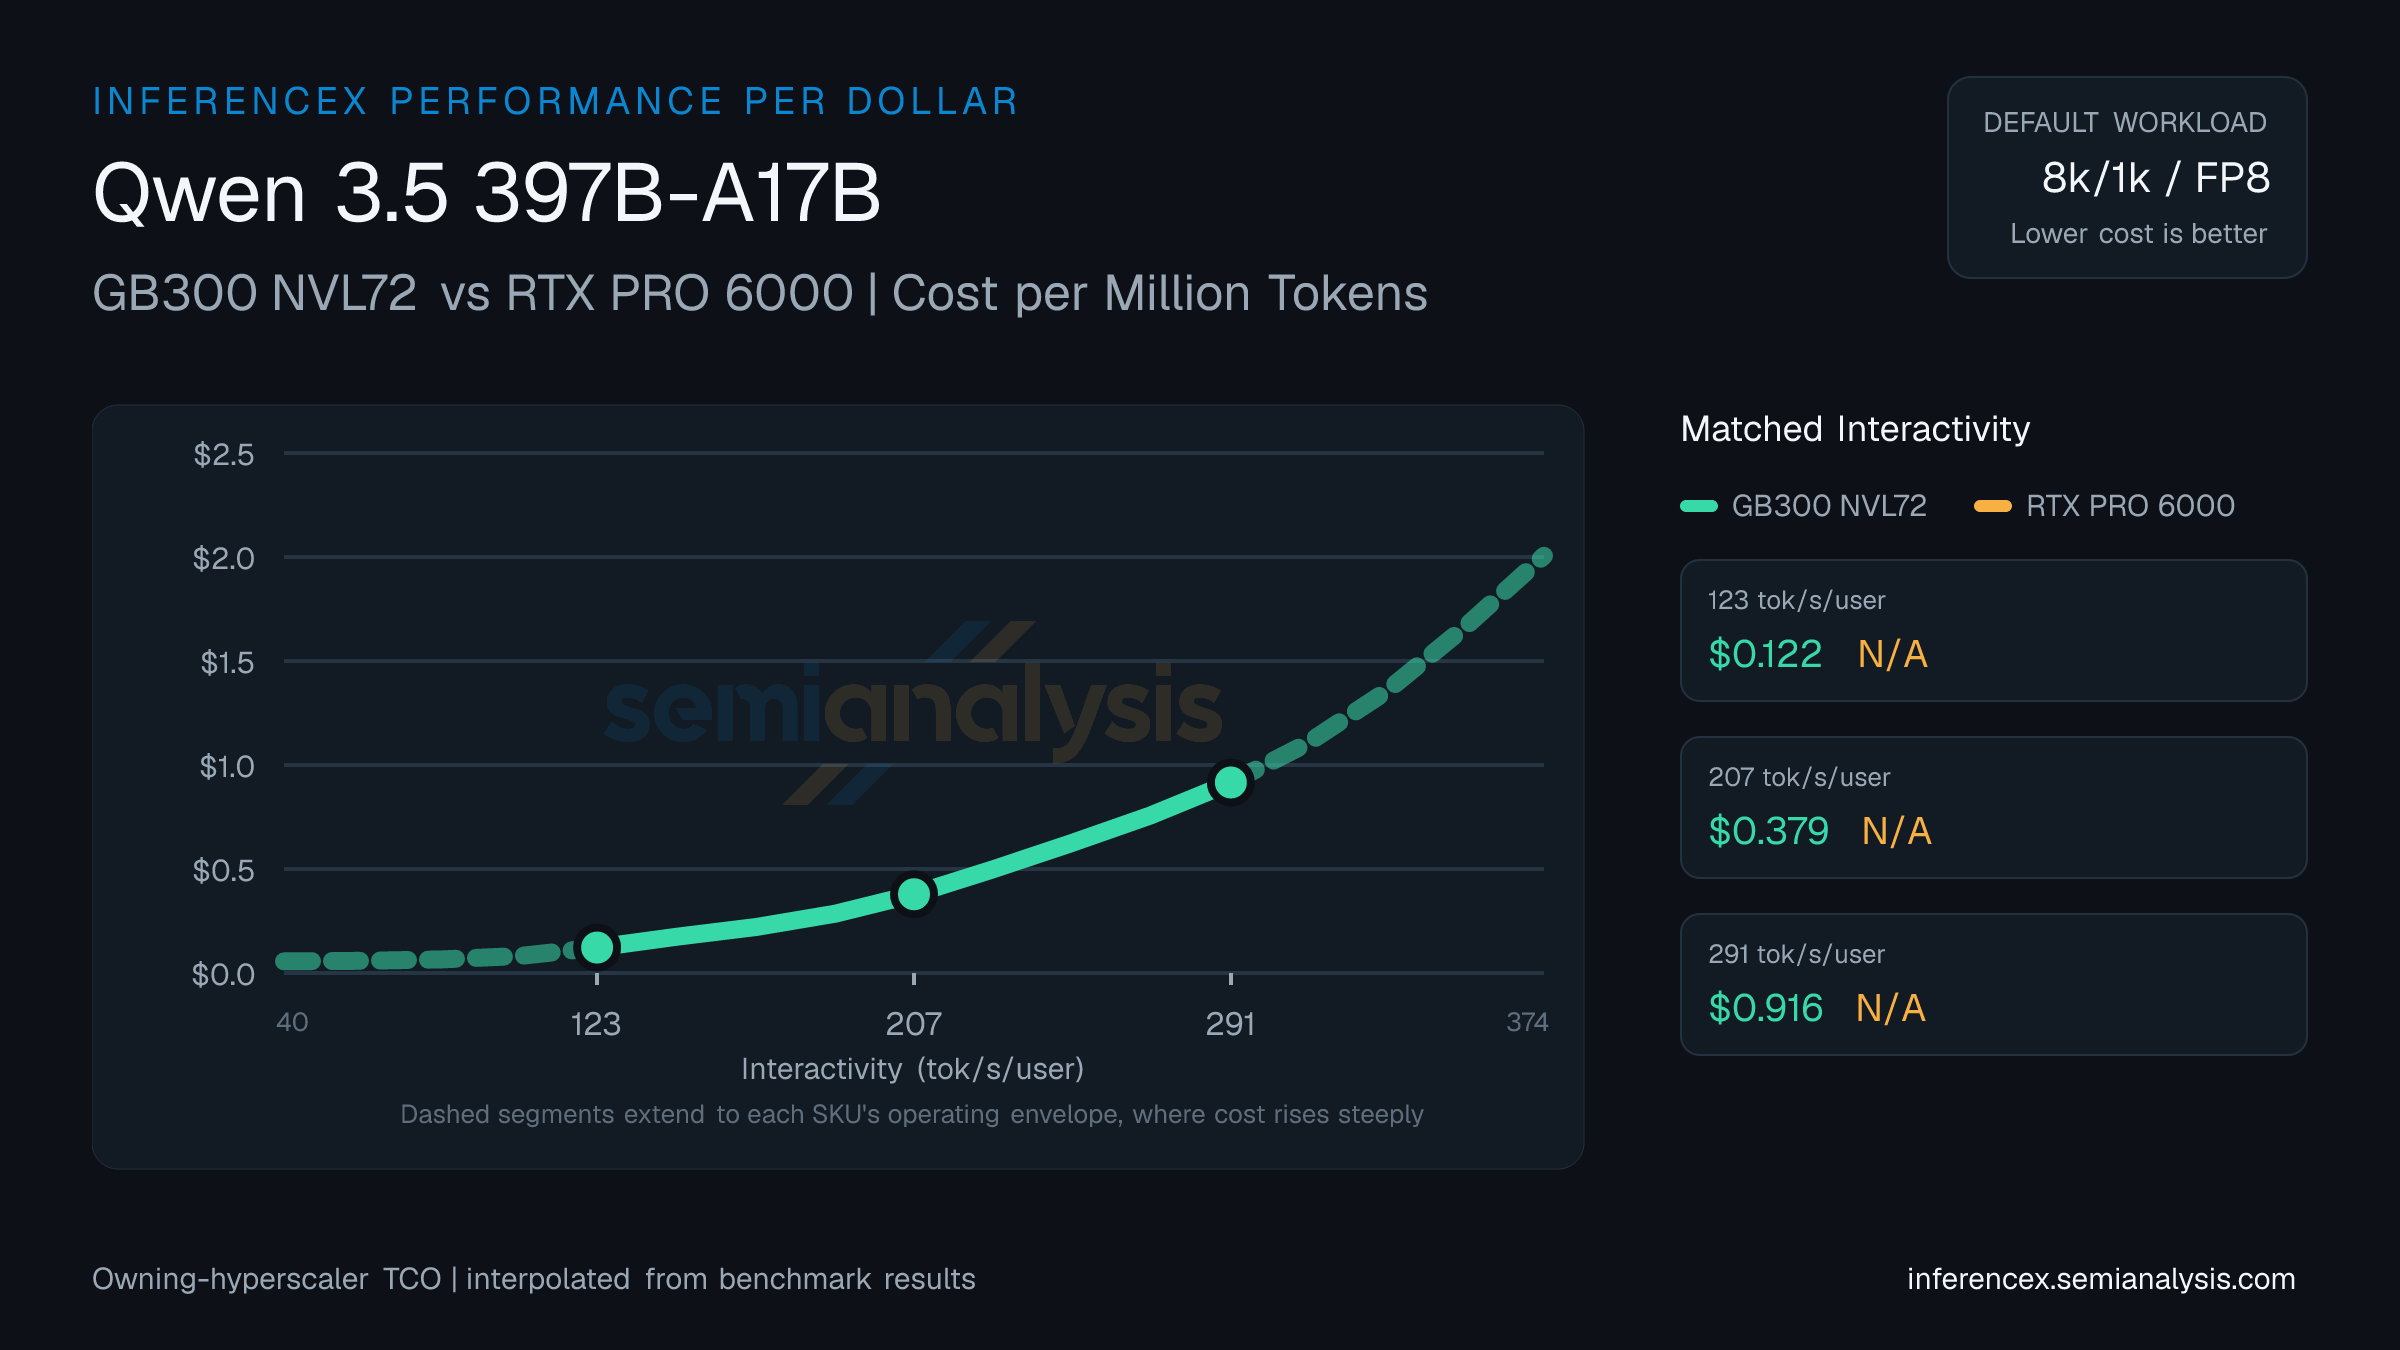
GB300 NVL72(NVIDIA Blackwell)与 RTX PRO 6000(NVIDIA Blackwell)在 Qwen 3.5 397B-A17B 上的每百万 token 成本。基于所属云服务商 TCO 归一化的输出 token 性能——在各类 LLM 工作负载下的每美元性能。在每个目标交互性水平下选出更经济的 SKU。使用下方图表控件切换序列、精度和指标——交互方式与主推理图表相同。
在 Qwen 3.5 397B-A17B 上以 56 tok/s/user 运行时,GB300 NVL72 每百万 token 成本为 $0.02,RTX PRO 6000 为 $0.18。GB300 NVL72 在此工作点上的成本效率高出 989%。
GB300 NVL72 在 Qwen 3.5 397B-A17B 上以 88 tok/s/user 运行时领先于 RTX PRO 6000——每百万 token 成本 $0.02 对 $0.25,差距达 1305%。
将 Qwen 3.5 397B-A17B 推至 121 tok/s/user 时,GB300 NVL72 每百万 token 成本为 $0.02,RTX PRO 6000 为 $0.40——GB300 NVL72 领先 1756%。 (数据反映此 URL 的默认 8k/1k · fp4 选择——如果您在控件中更改序列、精度或模型,下方表格和图表会自动更新。)
Chip 定价(所属云服务商): GB300 NVL72 $2.31/chip/hr · RTX PRO 6000 $0.68/chip/hr. 来源: SemiAnalysis Market July 2026 Pricing Surveys & AI Cloud TCO Model.
| Metric | Interactivity (tok/s/user) | Interactivity (tok/s/user) | Interactivity (tok/s/user) |
|---|---|---|---|
| Dollar per Million Tokens | GB300 NVL72:$0.017RTX PRO 6000:$0.184 | GB300 NVL72:$0.018RTX PRO 6000:$0.247 | GB300 NVL72:$0.022RTX PRO 6000:$0.400 |
| Concurrency | GB300 NVL72:~2983RTX PRO 6000:~10 | GB300 NVL72:~1205RTX PRO 6000:~4 | GB300 NVL72:~1088RTX PRO 6000:~2 |
推理性能
不同模型、硬件配置和服务参数下的推理性能指标。